Friday, 23 July 2010
Milano-Bicocca improves its Webometrics ranking
Webometrics ranking of world universities shows information about world universities, ranked according to indicators measuring web presence, link visibility, size and number of documents available for download. Since 2004 this chart is done by the Spanish National Research Council, and gets updated every six months.
Milan-Bicocca's website has a strongly positive trend as we raised 325 positions since 2007; during the last year we jumped 19 positions.
Observing the data, one notes that we pay for the size of our site, intended as the "number of pages recovered on four different search engines". We have a lot of information spread on satellite website, like faculties. It's not clear, according to the methodological note, if those pages are counted or not.
Moreover, there's an important issue connected with our research institutions. Isidro Aguillo, editor of the ranking, writes: "the rankings of universities of Germany, France, Italy and Spain come later [than British and nordic ones], mostly due to the fact that research in this countries is developed by independent institutions (Max Planck, CNRS, CNR, CSIC)". Therefore, our ranking is strongly lowered by this kind of structure.
Monday, 12 July 2010
Frenare un'emorrargia di naviganti
Questo grafico mostra il numero di "rimbalzi" che i visitatori del sito della Bicocca effettuano da una pagina molto particolare: quella delle Facoltà. Purtoppo, per ragioni storiche, gli studenti associano il corso di laurea al concetto di facoltà. Navigando sulla home page, ricercano le informazioni sui corsi cliccando proprio su facoltà e di lì abbandonano il sito affidandosi ai siti satellite.
Come evidenzia il popup dello screenshot, nei primi di luglio questa tendenza ha raggiunto livelli parossistici, con migliaia di visitatori ogni giorno ad abbandonare il sito dopo un click alla ricerca (vana) di informazioni sui corsi di laurea. Abbiamo quindi deciso di rivedere la pagina per tamponare l'emorrargia.
La prima cosa che abbiamo deciso è stato di conservare, in ogni caso, le informazioni che già prima erano presenti nella videata. Dunque, sede, preside e link al sito di Facoltà sono ancora al loro posto; per assicurare visibilità a tutte e otto in egual misura, abbiamo previsto un menu sulla destra. Il grosso della paginata è dedicato però all'elenco dei corsi di laurea, ben suddivisi per tipologia e corredati da un motore di ricerca interno.
Il risultato è eclatante: come mostra il grafico, nel giro di un giorno i rimbalzi sono crollati a zero.
Monday, 28 June 2010
L'usabilità e la scelta del corso di studi
Come sempre in questo periodo, stiamo lavorando alla pubblicazione dell'offerta didattica del prossimo anno accademico. Poichè il nostro ateneo ha una certa grandezza, l'offerta complessiva è decisamente vasta, organizzata in otto facoltà per un totale di circa 70 corsi di laurea differenti, tra triennali, magistrali, UNA specialistica residua (scienze infermieristiche ed ostetriche), "a ciclo unico" e l'ultima vecchio ordinamento (formazione primaria). Non è semplice, per chi visita il sito, orientarsi in questa selva di corsi, e ogni anno si da fondo alla creatività cercando l'organizzazione migliore.
Inoltre, per ragioni storiche, gli studenti tendono a confondere il concetto di "corsi di laurea" e "facoltà". Dai test di usabilità condotti da Stefano lo scorso inverno è emerso che tantissimi visitatori si perdono seguendo i link alle facoltà, credendo di arrivare alle informazioni di un corso di laurea e finendo invece a navigare sui siti satellite. Quest'anno abbiamo riorganizzato completamente la navigazione e tenteremo di frenare questa emorrargia, anche con un motore di ricerca dei corsi di laurea un po' smart.
Conosci il tuo nemico
Partendo dal presupposto che gli studenti non sono tenuti a conoscere l'organizzazione interna dell'Ateneo, abbiamo cercato di rendergli la vita semplice proponendo un motore di ricerca basato sull'elaborazione del testo inserito. Ho cercato di andare oltre il triviale pattern match, perché come detto auspichiamo una certa "tolleranza semantica".
Dunque, uno studente troverà il CdL in "informatica" sia cercando la parola stessa che inserendo "laurea in informatica" o "facoltà di informatica", ma anche cercando altre parole correlate. In sostanza, ho associato ad ogni CdL un insieme di termini che potrebbero essere inseriti dall'utente alla ricerca di quello specifico corso. Naturalmente, le parole di poca rilevanza vengono scartate automaticamente. La ricerca avviene tramite javascript asincrono e quindi in tempo reale senza caricamento.
Una parte interessante è che la complessità insita nell'identificazione del CdL - come sapere a che facoltà afferisce e come si chiama esattamente - viene del tutto mascherata: inserendo brandelli di parole viene generata una lista che potrebbe addirittura suggerire nuovi percorsi agli immatricolandi.
Inoltre, per ragioni storiche, gli studenti tendono a confondere il concetto di "corsi di laurea" e "facoltà". Dai test di usabilità condotti da Stefano lo scorso inverno è emerso che tantissimi visitatori si perdono seguendo i link alle facoltà, credendo di arrivare alle informazioni di un corso di laurea e finendo invece a navigare sui siti satellite. Quest'anno abbiamo riorganizzato completamente la navigazione e tenteremo di frenare questa emorrargia, anche con un motore di ricerca dei corsi di laurea un po' smart.
Conosci il tuo nemico
Partendo dal presupposto che gli studenti non sono tenuti a conoscere l'organizzazione interna dell'Ateneo, abbiamo cercato di rendergli la vita semplice proponendo un motore di ricerca basato sull'elaborazione del testo inserito. Ho cercato di andare oltre il triviale pattern match, perché come detto auspichiamo una certa "tolleranza semantica".Dunque, uno studente troverà il CdL in "informatica" sia cercando la parola stessa che inserendo "laurea in informatica" o "facoltà di informatica", ma anche cercando altre parole correlate. In sostanza, ho associato ad ogni CdL un insieme di termini che potrebbero essere inseriti dall'utente alla ricerca di quello specifico corso. Naturalmente, le parole di poca rilevanza vengono scartate automaticamente. La ricerca avviene tramite javascript asincrono e quindi in tempo reale senza caricamento.
Una parte interessante è che la complessità insita nell'identificazione del CdL - come sapere a che facoltà afferisce e come si chiama esattamente - viene del tutto mascherata: inserendo brandelli di parole viene generata una lista che potrebbe addirittura suggerire nuovi percorsi agli immatricolandi.
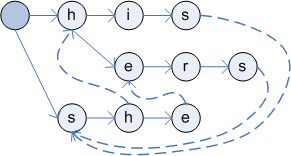
Aho-Corasick (multiple pattern match) in PHP
When I started programming Mergifier, my "RSS feeds dispenser", I knew I was going to need some kind of terms filtering. It's useless to take into account the most common words, for they don't bring any information.
My initial solution was to split the text into an array of substrings and use array_diff to remove those in my blacklist array. I don't know the asymptotic cost of array_diff algorythm, but using it with plenty of items (featuring long titles, summaries and descriptions) soon appeared a bit too expensive.
Recently I studied a lot of pattern matching algorythms, including the well known "Aho-Corasick" which checks occourrences of multiple patterns "at once" inside a text of length n in O(M+n), being M the total number of characters composing the patterns. Useful for virus signature detection and bioinformatics, I did not find its implementation anywhere, so I did my own!
Download the code
As you could see inside the code, this algorythm is cool because one can precalculate delta/phi transition tables and cache them, brutally speeding up computations on many different texts made of many terms.
If you find this code useful, or if you have any kind of suggestion to improve it, please let me know. :)
Friday, 11 June 2010
Mergifier: prima alfa
Mergifier è entrato in funzione! Attualmente si occupa di classificare le notizie di interesse per studenti, docenti e dipendenti. Questi sono i link per sottoscrivere i feed ATOM:
Il progetto è in una fase embrionale e potrebbe manifestare qualche malfunzionamento; aiutaci segnalando bug o eventuali suggerimenti via email o sul canale facebook! :)
Subscribe to:
Posts (Atom)